过去,我们学习批判性思维时,得到的教导是:面对新信息,保持谦逊、好奇和适度的怀疑,听取不同观点,再形成自己的判断。这些原则依然成立。但如今,我的大量工作都交给了智能体,日常工作中,越来越少有事情会迫使我主动思考和质疑。对于那些已经全面采用智能体工作流的工程师和产品人员——同时运行多个会话,并期待模型继续进步的人——我想先说清楚:我非常喜欢这些工具。写这篇文章,并不是为了倡导减少使用智能体。
我的目标是:在一个什么都可以轻易交给智能体的世界里,帮助你保持批判性思维。
过去,我们的大部分认知活动和审美判断,都发生在提出问题与获得答案之间。如今,这段间隔缩短到了几秒。越依赖智能体工作流,保持批判性思维就越困难,不过原因可能与大家预想的不同:随着模型进步,明显错误的比例越来越低。许多输出,甚至可能大多数输出,都会文笔流畅、基本正确,让你感觉没有必要再看一遍。
即使你同时运行着许多智能体,审阅输出的也依然只有你这一双眼睛。
你必须主动把批判性思维安排进日常工作,因为默认情况下,没有什么会替你做到这一点。
之所以很难自行纠正这种倾向,部分原因在于:智能体工作流用起来很舒服。在忙碌的一天里,快速获得令人满意、而且往往正确的答案,让人倍感轻松。但也正因如此,你很容易放松警惕。
认知卸载、判断让渡与认知投降
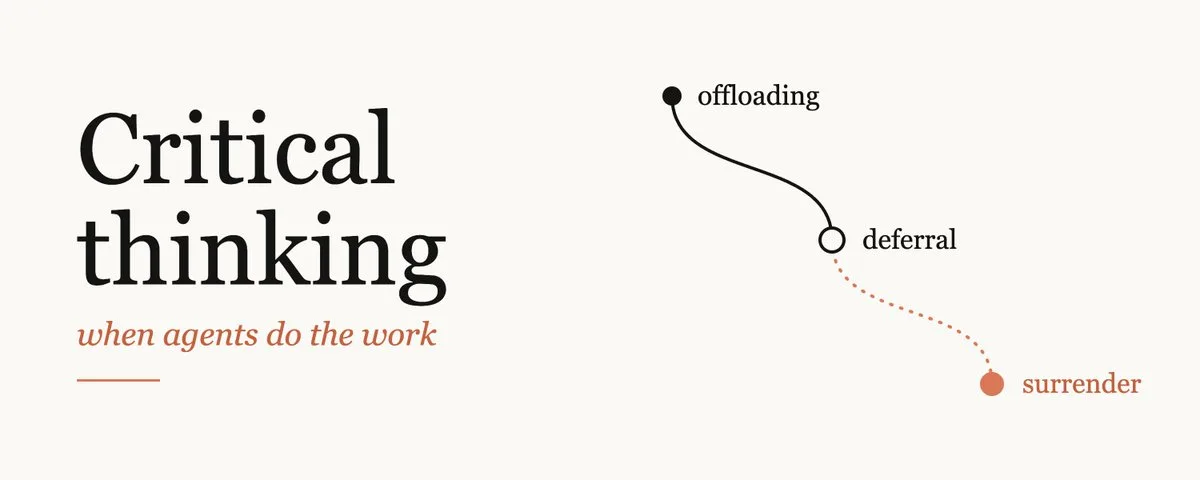
与别人讨论这个问题时,我通常把它描述成一个连续的谱系:
最上端是认知卸载:把任务交给 AI,但仍然对结果负责。我每天都在这样做,你也应该这样做。
中间是判断让渡:工具的输出直接成为你后续工作的输入,这个结果不再被视为一个有待检验的假设。
最下端则是认知投降:AI 的输出悄然变成了你自己的观点,你觉得已经没有必要核查。
“认知投降”这个术语由沃顿商学院的 Steven Shaw 和 Gideon Nave 提出。它准确描述了我观察到的现象:随着信任增加,或者人变得更懒,人们会沿着这个谱系逐步下滑。这个过程很少被察觉,因为每一步都很缓慢,看起来也都合情合理。上一份回答你认真读过,于是下一份就略读一下;再下一份,只扫一眼框架。直到有人问起其中某一行,你才发现,即使有智能体帮忙,你也解释不清楚。
这就是认知投降,也是认知债务积累的方式。通常,当你试图依靠脑海中的系统模型来解决问题,却发现那个模型根本不存在时,问题才会暴露。Margaret-Anne Storey 写过,这在团队中表现为:大家对系统如何运作的共同理解逐渐流失。我也写过它在代码中的对应物:理解债务,这个术语由 Jeremy Twei 提出。
在当下,这种债务完全不可见。代码库看起来整洁无瑕,测试全部通过。直到你需要修改系统,才突然意识到,已经没人理解它了。同样的问题,也会出现在你只看过一份战略文档或规格说明的目录,就签字认可的时候。
需要说明的是,我并不是要求大家做到不可能的事。对于一个庞大的现代代码库,不可能始终在脑海中维护完整的模型。Claude Code 团队曾公开表示,他们会按需重建理解:需要理解某一部分时,就让 Claude 解释那一部分,而不是把整个系统模型都装在脑子里。正如我之前写过的,这类债务比大多数工程师想象的更容易偿还。只要你能在需要时重建对局部的理解,就不必始终维护完整模型。你只需要清楚,自己缺少哪些理解。
风险低的事情,可以放心全部交出去。但如果一个问题的答案,连借助智能体都解释不清,你就已经放弃了对它的掌控。
这也并不总是问题。前不久,我录制一门课程,需要从三家评分相近的酒店中挑一家作为录制地点。我没时间逐条查看所有评论,于是把决定交给了 AI。结果很好,下次我还会这么做。
但在决定如何投资、如何给孩子提供职业建议,或者在工作中决定该做什么产品、哪些改动会影响哪些用户、是否可以安全发布时,我不会这样做。出错代价低的事情,可以交出去;如果后果需要别人承担,你就应该保留自己的推理和判断。
我会问自己的问题
当我不确定自己究竟怎么想时,通常会回到一组基本问题:我怎么知道自己正在解决正确的问题?我怎么知道解决方式是对的?有什么证据支持我的结论?我怎么知道工作已经完成?
大多数时候,这些无非就是谁、什么、哪里、为什么、何时以及如何。写出来似乎幼稚得可笑,但它会迫使你从一些原本可能忽略的角度思考。如今,跳过这一切,直接问智能体“你觉得我应该怎么办”,实在太容易了。下面是我现在会问自己的新版问题。
提问之前,我有没有先形成一个假设? 在让智能体执行任何有一定复杂度的任务前,我会先写下自己认为可能的答案,哪怕只是在脑海里过一遍。猜得不好也没关系。获得新信息后,你随时可以改变想法。但一旦读过一份写得很有说服力的回答,就很难再想象其他可能性。如果你完全没有头绪,可以让模型做一次 Thariq Shihipar 所说的盲点扫描:把你已知的信息交给它,让它找出那些你连自己不知道都未曾意识到的事情。
我是在请它帮助我思考,还是把思考交给它? 两者都可以,前提是你清楚自己正在做哪一种。
在什么情况下,这个结论会是错的? 然后去查证。模型对自身信心的评价,远不如一个你能实际执行的检验有价值。所以,给它一个可执行的检验。
我有没有从不同角度听过反方意见? 当我对一个尚无定论的问题持有强烈立场时,会请不止一个模型站在对立面展开论证,再审阅输出,形成自己的判断。这会花更多时间,但我最终也会对问题了解得更多。
面对今后要维护它的人,我敢为这个结果打包票吗? 这既适用于代码,也适用于你交付的任何东西。我认为,这就是能够为结果负责的标准。
我有哪些能力已经不再练习了? 也许是某些日常调试能力。我可以接受放下一部分,但我希望这是有意识的选择。
把验证变成习惯
最近,我写了很多关于验证的内容,因为我认为,瓶颈已经从编写代码转向确认自己做得对不对。
当你为智能体提供验证手段,无论是端到端测试、基于性质的测试,还是直接与应用交互,它都可以在你查看任何东西之前,完成修改、运行验证、读取输出,再尝试修正。这就是 Boris Cherny 所说的“给 Claude 一种验证自己工作的方式”。我认为,这是获得出色结果最关键的环节之一。你的工作会从逐行阅读,转向构建这些验证循环,并审阅证据。
但你也可能在验证环节放弃判断。“有没有证据支持我的结论?”会变成“检查是不是变绿了?”
智能体让编写测试变得非常便宜,于是你会看到大量绿色结果。但测试通过,并不代表它能发现功能已经损坏。如果测试和功能实现犯了同样的错误,测试照样会通过。而且,一个绿色对勾只说明某一项性质得到了验证,人却很容易以为它覆盖了一切。
检查变绿时,先问它证明了什么,再问它没有证明什么。
提前定义什么叫“验证通过”,因为事后,你会为任何结果找到合理化的解释。
智能体工作的终点应该是具体可见的东西:一次通过的测试、一张截图、一段日志或一条执行轨迹。这样,完成标准就建立在事实上,而不会因为“看起来已经做完了”之类的感觉,变成可以随意解释、甚至放弃判断的东西。
收到智能体的完成通知时,先别看总结,先查看它实际执行的命令及其输出。
Claude Code 也可以通过一个使用全新上下文的子智能体,对自己的工作进行审查,作为一次合理性检查。应该把这个步骤固定进循环,让它每次都运行,而不只是想起来时才做。
我最后还是会问一句:“我漏掉什么了吗?”听起来有点傻,但很多时候,我用前沿模型完成一项复杂功能,自己看过、审过,再问一句“我漏掉什么了吗?”,它就会再找出两三件事。所以我总会问。
当然,也不需要每次都做到这个程度;知道什么时候需要深入,本身就是一种能力。在我们介绍 Claude Code 团队如何做代码审查的文章中,我最喜欢的一条经验是:“如果你说不清现有检查会漏掉什么,就应该要求一次认真审查,而不是快速批准。”
这同样适用于代码之外的工作。如果智能体帮你汇总了五十次客户访谈,或做了一份竞争分析,就抽查几份原始材料,确认总结准确。对于支撑你建议的关键数字,也要检查它是否计算正确。
智能体已经让搭建验证变得便宜。对你来说,难的是知道什么样的验证才算好。
真正关注生成的内容
假设智能体给了你一个六百行的 PR。你大致看了结构,没有逐行阅读。变量名看起来合理,测试也通过了,于是你批准了。
但代码中间某处,可能悄悄改变了事务边界处的执行顺序,或者把某个你从未考虑过的边界情况下的默认行为反了过来。你大概确实审查过,只不过,你只检查了自己原本就知道要找的东西。
编写代码和审查代码是两种不同的能力,而且审查可能在某个节点退化成例行盖章。因此,阅读差异时,要像审查普通代码一样认真;然后再越过差异本身,看看智能体做了哪些决定。
在一次长会话中,它会替你做出许多小决定:默认值是什么,哪些事情不在范围内,当两项要求冲突时重新解释哪一项。
这些都不会出现在一份声称“一切顺利”的总结里。所以,让它列出自己做过的决定和假设。然后考考自己:随机挑几行,问问这一行为什么这样写,那一行又为什么这样写。
对于文档,可以先关掉它,试着凭记忆写出核心论点。有些人在长会话中采用一种我很喜欢的做法:让 Claude 写一份变更报告,并在末尾附上一套测验,规则是“只有测验全部答对,我才会合并。”
你要充分理解自己交付的东西,理解到能够为它辩护。因为迟早可能有人会问。
智能体也可以帮助你保护注意力。例如,我维护的一个开源项目会收到大量 PR。我会用智能体帮助判断:有哪些新提交,哪些违反项目规范,哪些地方可能需要我重点关注。
我很少让智能体独自决定这些事,但它们可以帮我缩小关注范围。这样,我才能真正思考:这些改动是否在用正确的方式解决正确的问题。
接下来还有工作量的问题,你必须诚实面对。我把它称为编排税:智能体生成的内容,与那些你愿意署上自己名字的内容之间,存在一道差距。
如果已完成的工作堆积速度超过了你审阅的速度,那么在解决这个问题之前,再开一个会话也无济于事。你需要加强检查,让更少的内容必须由你亲自处理,或者放慢速度。
当你产出的东西已经多到无法为其负责时,你做的就不再是审查,而是在寄希望于它没问题。
好的输入,才有好的输出
人的心智模型依然参与其中,只是位置从中间移到了开头和结尾。你的精力投入到任务前端的描述与上下文,以及任务后端的输出审查。这就是为什么好的输入对输出质量如此重要,也是为什么我把编写好提示词视为一种批判性思维能力。
过去,如果你提出一个不具体的要求,通常会有人追问,让你意识到:“等等,其实我还没想明白。”
智能体往往不会在这里拦住你。它会补齐你省略的部分,交回一份看起来已经完成的成果,尽管背后的想法依然模糊。我把这种问题称为意图债务:那些存在于非你亲手编写的产物中,却没有被明确说明的目标、约束和理由。
与其他债务不同,这一种没人能替你解决。意图必须来自你。
提示词反映了你对问题的理解。如果你表达不清楚,可能是因为你自己也没想清楚。
求助之前,先用自己的话写一份任务说明。说明受众是谁、哪些事情不在范围内,以及怎样才算完成。如果第二轮纠正后仍未得到想要的结果,就别再小修小补,重新写提示词。
你也可以让智能体帮助你完成这一步。我喜欢 Andy Clark 对“把任务交给 AI 系统”和“与 AI 协作”所做的区分。
在协作中,你们处于一种相互增强的良性循环:更清晰的提示词带来更好的输出,更好的输出又帮助你改进下一轮提示词,并深化你对问题的理解。如果事情还不清楚,就让智能体围绕它不理解的地方采访你。如果会话结束时,你自己的心智模型变得更完善了,那就是成功的信号。
也要小心输入材料。每个智能体都很容易直接把上一个智能体的总结放进自己的上下文。没过多久,第三个智能体就已经完全没读过原始文档了。
你还需要为输出建立自己的标准。我在许多创作媒介中尝试过 AI,但大多数成果从未公开,因为它们达不到我的标准。如今,生成的东西都排版漂亮、语气自信,因此,精致的表面已经不再是有效的质量信号。
AI 也许让产出更快了,但如果我不愿意把成果署在自己名下,我就不会发布它。
当某个成果达不到标准时,把原因记录到共享配置、钩子或测试中,避免同样的问题再次出现。品味就是这样不断积累的。而且,记录某个结果为什么没有过关,本身就是一种好习惯。
“但模型会比我更擅长这些”
如果你像我身边许多人一样,非常看好这个领域的未来,那么读到前面几节时,你可能已经在想:再过一两年,模型就能发现我能发现的问题了,为什么还要费力维持这项能力?
在许多问题的识别上,你可能是对的。我自己也一直主张,把越来越多的问题检测交给智能体。但我仍然认为这些能力很重要,原因在于:最终,总得有人对交付结果负责。无论 AI 提供了多少帮助,都必须有人承担责任。
对于某个具体任务,应该信任智能体到什么程度,本身就是一个需要判断的问题。要让判断保持准确,就需要审查它的工作,因为模型会犯什么错,一直在变化。
Anthropic 对内部工程师和研究人员的研究指出了这个陷阱,并将其称为“监督悖论”:监督 Claude 所需的,恰恰是那些可能因过度使用 AI 而退化的编程能力。
对我来说,最重要的一些问题,是更强的模型也无法替我解决的:你在构建什么?为什么值得做?它会影响谁?你愿意为此牺牲什么?
这些问题都需要你回答。智能体可以帮助你想清楚,我也希望它能帮忙,但最终,问题仍然属于你。
你可以把工作和大部分审查交出去,但不能把责任交出去。
日常可以做的练习
你不需要严格执行这里的每一种做法。挑选适合自己工作流的就好。
每周,离开智能体写一点代码,或者亲手做一件你不愿失去能力的实际工作。我曾把它称为校准练习,但这不是道德上的要求。
每月,写下自己已经不再做的事情,再决定其中哪些是你可以接受不再做的。我以前一篇文章里的一个问题,到今天仍然有效:如果没有 AI,你会有多不知所措?
如果有些东西超出了你的理解,就去学。写作时,如果碰到一个没见过的说法,我当然可以搜索一句话解释,然后把它放进文章。但我更愿意做一点研究,真正理解它,知道它与其他知识有什么联系。
认真检查机器的工作,本身就是一项实实在在的工作。团队假装它不需要成本,最终就会没人去做。它不是免费的,所以把它作为一个明确的工作项安排进日程,你才会真正完成它。
停止练习的能力会逐渐消失,而且速度可能比你想象的更快。 那些你不愿失去的能力,就继续使用。
请记住这些
- 有意识地安排。 智能体可以考你、采访你、向你展示证据,但前提是你把这些环节设置好。所以,去设置。
- 诚实面对自己在谱系中的位置。 如果连借助智能体都解释不清答案,你就已经放弃了判断。
- 先有假设。 提问之前,先形成一个假设,哪怕猜得不好。
- 绿色对勾只证明一件事。 它检查了什么?又没有检查什么?
- 寻找证据。 先看它运行了什么、返回了什么,再读总结。
- 读懂它做过的决定。 它替你决定了什么?
- 认真编写提示词。 你如何表述请求,反映了你对问题理解了多少。
- 设定标准,并坚持。 如果你不愿署上自己的名字,就不要发布。
亲手运用那些重要的能力,让自己始终参与其中。你可以尝试这样做:提问之前,写下你认为会发生什么;智能体完成之后,写下它没有检查的一件事。欢迎告诉我,这是否改变了你阅读输出的方式。
独立思考。提出更好的问题。对结果负责。
原文链接: Critical thinking when agents do the work 本译文链接:#当智能体替你工作时,如何保持批判性思维